Ein praktischer Leitfaden für klaren Klang in KI-Videos

Audio-Ducking in KI-Videos verwenden (Schritt für Schritt)

Audio-Ducking sorgt dafür, dass Sprache klar verständlich bleibt, indem Hintergrundmusik oder andere unterstützende Klänge während des Sprechens leiser werden. In diesem Leitfaden erfahren Sie, wie Sie diesen Mix auf ein KI-generiertes Video anwenden, was Sie vor dem Export prüfen sollten und wie Sie häufige Probleme vermeiden, etwa wenn Musik den Dialog überdeckt. Mootion unterstützt Audio als Smart-Reference-Eingabe, aber die bereitgestellten Funktionsinformationen dokumentieren weder Bedienelemente für Audio-Ducking noch einen Workflow zum Abmischen. Am besten erstellen Sie zuerst die visuellen Inhalte und gleichen anschließend den fertigen Ton mit einem Audio- oder Videoeditor ab, der Lautstärkeautomation bietet.

Videoproduktion entdecken Ein zweistufiger Workflow: erst generieren, anschließend den Ton abmischen.

Ein Produktüberblick. Das Video bietet einen allgemeinen Einblick in die Erstellung von KI-Videos und ist keine Anleitung zu Audio-Ducking.

Was ist Audio-Ducking in KI-Videos? (Kurz erklärt)

Audio-Ducking ist eine Abmischtechnik, bei der eine Audiospur – häufig die Hintergrundmusik – vorübergehend leiser wird, sobald ein wichtigerer Klang wie ein Sprechertext oder Dialog einsetzt. Im Workflow für KI-Videos ist es ein abschließender Schritt, um generierte oder ausgewählte Audiospuren mit Sprache auszubalancieren, und keine Methode zur Videogenerierung. Nützlich ist es für Erklärvideos, Lektionen, Produktvideos und erzählerische Clips, bei denen die gesprochenen Worte gut verständlich sein müssen.

So fügt sich Audio-Ducking in einen KI-Video-Workflow ein

Unterscheiden Sie zwischen den Funktionen des Videogenerators und den Aufgaben im Audiomixer. Die verfügbaren Informationen zu Mootion beschreiben Audio-Referenzeingaben und Modi zur Videoerstellung, jedoch keine Ducking-Einstellungen.

Instant Mode und Smart Reference

Dieses Video stellt Instant Mode und Smart Reference für Bild-, Video- und Audioeingaben vor. Instant Mode erstellt direkt aus einer Eingabeaufforderung ein Video mit einer angegebenen Höchstlänge von 15 Sekunden. Aus den bereitgestellten Informationen geht nicht hervor, dass Smart Reference Audiopegel anpasst oder Ducking anwendet.

Ein filmisches Beispiel mit Dialog und Musik

„Aliens Arrival“ ist ein bereitgestelltes Beispiel mit Dialog und Musik. Es kann Ihnen dabei helfen, das Verhältnis zwischen gesprochenen Zeilen und Soundtrack zu beurteilen, ist aber nicht als Demonstration von Ducking-Steuerelementen dokumentiert.

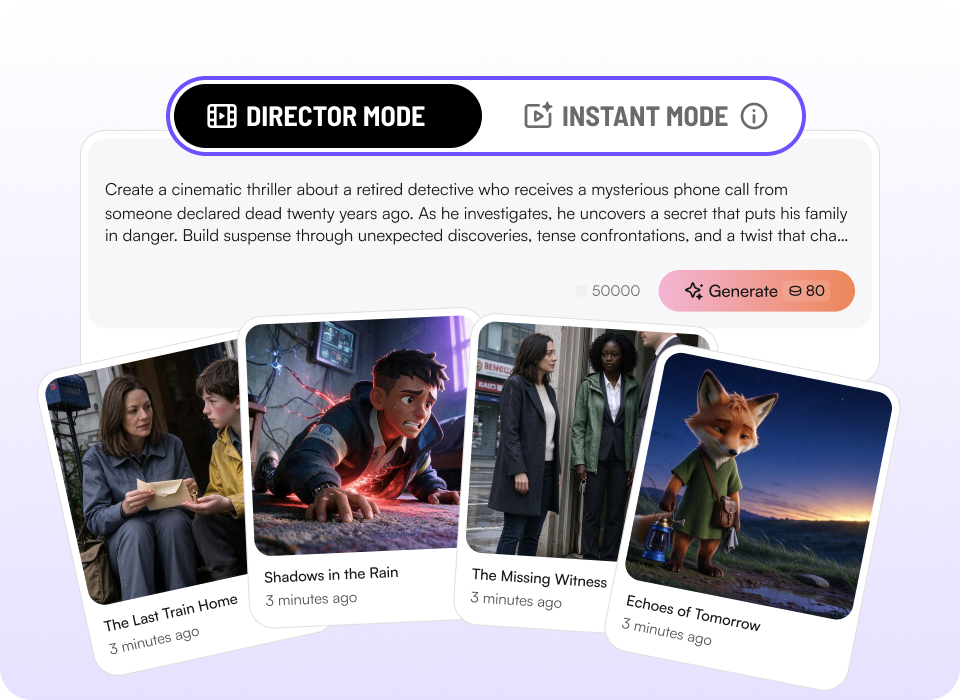
Illustration der Optionen Instant Mode und Director Mode für die Erstellung von KI-Videos

Wählen Sie einen Modus zur visuellen Gestaltung

Verwenden Sie Instant Mode, wenn Sie mit einer Eingabeaufforderung starten, oder Director Mode für eine storyboardbasierte Videoerstellung. Planen Sie für den Tonabgleich einen separaten abschließenden Arbeitsschritt in einem Editor mit Lautstärkeautomation ein. Erfahren Sie mehr über Workflows von der Eingabeaufforderung zum Video und die Szenenplanung mit Storyboards.

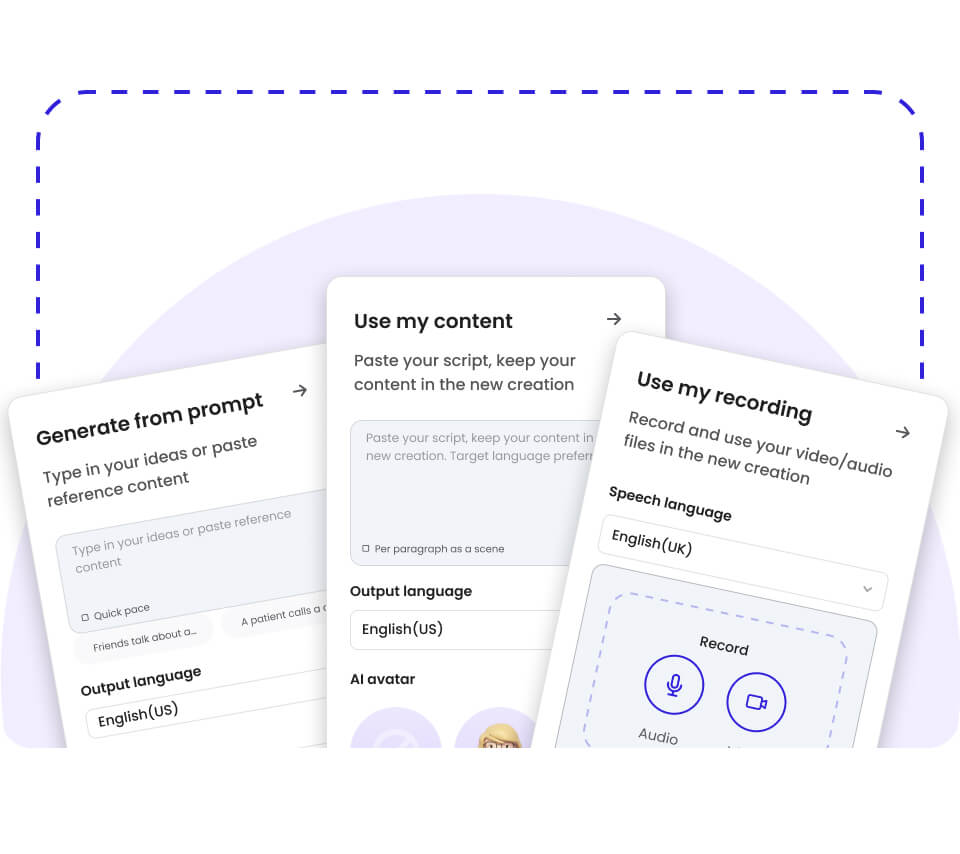
Illustration mit Eingabeaufforderung, vorhandenem Inhalt und Aufnahme als mögliche Ausgangspunkte für einen Video-Workflow

Eingabe und Abmischung getrennt betrachten

Mootions Smart Reference unterstützt Audio-Uploads neben Bildern und Videos. Die verfügbaren Details nennen jedoch keine Lautstärkeregler für hochgeladene Audiodateien. Weitere Informationen finden Sie unter Audio-Referenzeingaben und Audio-zu-Video-Erstellung.

Kurze Antwort (Beginnen Sie hiermit)

  • Generieren oder erstellen Sie das KI-Video und entscheiden Sie, welcher Ton im Vordergrund stehen soll.
  • Laden Sie das fertige Video von der Plattform herunter, wenn Sie Mootion verwenden; Video-Downloads werden unterstützt.
  • Öffnen Sie das Video in einem Audio- oder Videoeditor, der separate Audiospuren und Lautstärkeautomation unterstützt.
  • Sorgen Sie dafür, dass Dialog oder Sprechertext klar und gleichmäßig hörbar sind, bevor Sie die Hintergrundgeräusche anpassen.
  • Senken Sie die Musik während gesprochener Passagen ab und lassen Sie sie in Sprechpausen wieder ansteigen. Verwenden Sie allmähliche Änderungen statt abrupter Schnitte.
  • Hören Sie sich das vollständige Ergebnis über Kopfhörer und Lautsprecher an und passen Sie alle Stellen an, an denen die Sprache schwer verständlich ist.
  • Exportieren Sie eine Prüffassung und sehen Sie sie sich mit dem endgültigen Audiomix noch einmal an.

Voraussetzungen (Was Sie benötigen)

  • Eine KI-generierte Videodatei oder ein Videoprojekt, das für die Tonbearbeitung bereit ist.
  • Dialog, Sprechertext, Musik oder andere Audiodateien, die in den endgültigen Mix gehören.
  • Einen Audio- oder Videoeditor mit Lautstärkeautomation auf Spurebene.
  • Die Berechtigung, das Video und alle darin verwendeten Audioelemente zu nutzen.
  • Kopfhörer oder Lautsprecher, um Sprachverständlichkeit und Klangbalance zu überprüfen.

Die dokumentierten Funktionen von Mootion sind für die Videogenerierung hilfreich: Instant Mode unterstützt die promptbasierte Erstellung und Smart-Reference-Eingaben, während Director Mode die storyboardbasierte Erstellung unterstützt. In den verfügbaren Funktionsinformationen ist kein integriertes Audio-Ducking-Steuerelement aufgeführt.

Schritt für Schritt: Audio-Ducking in einem KI-Video verwenden

Schritt 1: Stellen Sie zuerst das visuelle Video fertig

Erstellen Sie die Szenen und überprüfen Sie die Bildfolge, bevor Sie mit dem Abmischen beginnen. Wenn Sie Mootion verwenden, wählen Sie Instant Mode für eine promptgesteuerte Erstellung oder Director Mode für einen storyboardbasierten Workflow. Keiner der beiden Modi ist hier als Audiomixer mit Audio-Ducking dokumentiert.

Erfolgskriterium: Das Video wird in der vorgesehenen Szenenreihenfolge abgespielt und ist bereit für die Tonbearbeitung.

Häufiger Fehler: Betrachten Sie einen Audio-Referenzupload nicht als Beleg dafür, dass die Plattform den Ton abgemischt oder Ducking angewendet hat.

Schritt 2: Bestimmen Sie den Vordergrundton

Entscheiden Sie, welcher Ton in den einzelnen Momenten Vorrang haben soll, etwa ein Sprechertext, ein Dialog oder ein wichtiges Geräusch. Markieren Sie die Abschnitte, in denen er gut hörbar sein muss, bevor Sie die Hintergrundmusik anpassen.

Erfolgskriterium: Sie können die wichtigen gesprochenen oder hervorgehobenen Momente benennen, die im Mix Raum brauchen.

Häufiger Fehler: Senken Sie nicht pauschal alle Tonspuren ab, ohne zuerst festzulegen, welche davon die Botschaft vermittelt.

Schritt 3: Öffnen Sie das Video in einem Editor mit Lautstärkeautomation

Laden Sie das Video herunter und öffnen Sie es in einem Editor, in dem Sie die Audiolautstärke im Zeitverlauf anpassen können. Wenn Ihr Bearbeitungsworkflow es zulässt, legen Sie Sprache und Hintergrundmusik auf separate Spuren, damit Sie beide unabhängig voneinander anpassen können.

Erfolgskriterium: Im Editor werden das Video und die auszugleichenden Audiospuren angezeigt.

Häufiger Fehler: Wenn Sprache und Musik bereits auf einer einzigen Audiospur zusammengeführt sind, prüfen Sie vor einer Pegelanpassung, welche Trennmöglichkeiten Ihr Editor bietet.

Schritt 4: Senken Sie die Hintergrundgeräusche während des Sprechens ab

Verwenden Sie Lautstärkeautomation auf der Hintergrundspur, um sie während Dialog oder Sprechertext leiser zu stellen. Ändern Sie die Lautstärke allmählich genug, damit es natürlich klingt. Wenn es zur Szene passt, können Sie den Hintergrundpegel wieder anheben, sobald der Vordergrundton endet.

Erfolgskriterium: Sprache ist leichter verständlich, während die unterstützenden Klänge weiterhin präsent, aber weniger dominant sind.

Häufiger Fehler: Vermeiden Sie abrupte Pegeländerungen, die den Mix statt der Handlung in den Vordergrund rücken.

Schritt 5: Hören Sie alles durch und exportieren Sie eine Prüffassung

Spielen Sie das gesamte Video ab, einschließlich der Übergänge zwischen gesprochenen Passagen und Pausen. Prüfen Sie, ob wichtige Wörter überdeckt werden und ob die Musik nicht unerwartet verstummt. Exportieren Sie anschließend eine Prüffassung und hören Sie sie außerhalb der Bearbeitungs-Timeline an.

Erfolgskriterium: Der Dialog bleibt durchgehend verständlich, und die Änderungen der Hintergrundlautstärke wirken beabsichtigt.

Häufiger Fehler: Geben Sie den Mix nicht allein aufgrund einer kurzen Vorschau einer einzelnen Szene frei.

Prüfliste (So stellen Sie sicher, dass es funktioniert hat)

  • ☐ Dialog oder Sprechertext ist in allen gesprochenen Abschnitten verständlich.
  • ☐ Hintergrundgeräusche sind leiser, während die Stimme im Vordergrund spricht.
  • ☐ Der Hintergrund kehrt während der Pausen und Übergänge auf eine passende Lautstärke zurück.
  • ☐ Lautstärkeänderungen klingen allmählich und nicht abrupt oder störend.
  • ☐ Wichtige Wörter und Geräusche werden nicht von der Musik überdeckt.
  • ☐ Das gesamte Video wurde überprüft, nicht nur eine einzelne Szene.
  • ☐ Die exportierte Prüffassung wird mit dem vorgesehenen Audiomix abgespielt.

Häufige Probleme und Lösungen

Problem Wahrscheinliche Ursache Praktische Lösung
Dialog ist schwer zu verstehen Hintergrundgeräusche konkurrieren mit der Stimme. Senken Sie die Hintergrundlautstärke während des Sprechens und hören Sie die gesamte Passage erneut an.
Die Musik ändert sich abrupt Die Lautstärkeautomation ändert sich zu schnell. Verwenden Sie sanftere Übergänge in den Abschnitt mit reduzierter Lautstärke und wieder heraus.
Der Hintergrund wird nicht leiser Die Anpassung wurde auf der falschen Spur vorgenommen oder nicht für den gesamten Sprachabschnitt angewendet. Prüfen Sie die ausgewählte Audiospur und kontrollieren Sie die Automation im entsprechenden Timeline-Bereich.
Der Ton lässt sich nicht separat anpassen Sprache und Musik sind in der verfügbaren Datei auf einer Spur zusammengeführt. Prüfen Sie, ob Ihr Editor eine geeignete Trennung ermöglicht, oder überarbeiten Sie den Mix mit separaten Quellspuren, falls verfügbar.
Der Mix klingt nach dem Export anders Die endgültig gerenderte Datei wurde außerhalb der Bearbeitungsansicht noch nicht überprüft. Spielen Sie die exportierte Prüffassung ab und nehmen Sie vor der Fertigstellung alle erforderlichen Pegeländerungen vor.

Bewährte Vorgehensweisen (So gelingt es langfristig)

  • Legen Sie vor dem Abmischen den Vordergrundton fest – so hat jede Lautstärkeanpassung einen klaren Zweck.
  • Halten Sie Sprache und Hintergrundquellen nach Möglichkeit getrennt – unabhängige Spuren lassen sich leichter ausbalancieren.
  • Ändern Sie den Pegel allmählich – sanfte Übergänge lenken weniger vom Inhalt ab.
  • Überprüfen Sie nach der Bearbeitung das gesamte Video – die Klangverhältnisse können sich von Szene zu Szene ändern.
  • Hören Sie sich den Mix auf mehr als einem Wiedergabesystem an – so erkennen Sie Probleme, die in einer einzigen Umgebung leicht zu überhören sind.
  • Speichern Sie eine Prüffassung, bevor Sie den Mix als endgültig ansehen – damit können Sie Unterschiede beim Export erkennen.
  • Halten Sie Erwartungen an Generierung und Abmischung auseinander – eine Audio-Referenzeingabe bestätigt für sich genommen keine Ducking-Unterstützung.

Bei Projekten mit wiederkehrenden Figuren oder Handlungssträngen sollten Sie überlegen, wie einheitliche KI-Videofiguren und die Planung von Sprechertext und Musik in Ihren Produktionsprozess passen.

Empfohlenes Tool (optional): Mootion

Mootion kann bei der Videogenerierung eines Projekts unterstützen. Die bereitgestellten Informationen beschreiben die folgenden Funktionen, dokumentieren aber weder Bedienelemente für Audio-Ducking noch einen integrierten Workflow zum Abmischen.

  • Beginnen Sie mit einer Eingabeaufforderung in Instant Mode, um direkt ein Video zu generieren.
  • Verwenden Sie Director Mode für eine storyboardbasierte Videoerstellung.
  • Nutzen Sie Smart Reference mit Audio, Bildern und Videos als Referenzeingaben.
  • Verwenden Sie eine wiederverwendbare Character Library, um die Kontinuität von Figuren über mehrere Projekte hinweg zu unterstützen.
  • Laden Sie das generierte Video herunter und passen Sie die Audiopegel in einem Editor mit Lautstärkeautomation an.

Verwenden Sie Mootion, wenn Sie Videoszenen aus Eingabeaufforderungen oder Referenzen erstellen möchten. Wählen Sie es nicht speziell für Audio-Ducking, ohne vorher zu prüfen, ob die benötigte Funktion verfügbar ist.

Häufig gestellte Fragen

Was ist Audio-Ducking in KI-Videos?

Audio-Ducking ist eine Abmischtechnik, bei der eine Hintergrundspur leiser wird, während ein wichtigerer Ton zu hören ist. In einem KI-Video bedeutet das meist, die Musik während eines Dialogs oder Sprechertexts abzusenken. Es handelt sich in der Regel um eine Anpassung in der Nachbearbeitung, die unabhängig von der Generierung der Videoszenen erfolgt.

Gibt es bei Mootion eine dokumentierte Audio-Ducking-Funktion?

Die bereitgestellten Informationen zu den Funktionen von Mootion dokumentieren weder eine Audio-Ducking-Einstellung noch einen Workflow zum Abmischen von Audio. Sie beschreiben jedoch, dass Smart Reference Audio-Uploads neben Bild- und Videoeingaben unterstützt. Für Audio-Ducking verwenden Sie nach der Videoerstellung einen Audio- oder Videoeditor mit Lautstärkeautomation.

Kann Smart Reference Musik während des Sprechens automatisch absenken?

Die verfügbaren Details beschreiben Smart Reference als Funktion für Audio-, Bild- und Video-Referenzeingaben. Es wird nicht angegeben, dass hochgeladene Audiodateien abgesenkt, abgemischt oder in ihrer Lautstärke angepasst werden können. Betrachten Sie die Funktion als Eingabeoption und nicht als Bestätigung eines Audiomix-Steuerelements.

Wie lässt sich Musik unter einem Sprechertext am einfachsten absenken?

Legen Sie Sprechertext und Hintergrundmusik in einem Editor mit Lautstärkeautomation auf separate Spuren. Senken Sie die Musik während gesprochener Abschnitte ab, verwenden Sie sanfte Übergänge und hören Sie sich vor dem Export das gesamte Video an. Überprüfen Sie neben der Bearbeitungsvorschau auch die exportierte Fassung.

Gibt es bei Mootion einen kostenlosen Tarif?

In den bereitgestellten Informationen wird Mootion nicht mit einem kostenlosen Tarif aufgeführt. Die aufgeführte Standard-Option kostet bei monatlicher Abrechnung 15 $ pro Monat. Bei jährlicher Abrechnung wird eine Jahresoption für 12 $ pro Monat genannt. Aktuelle Tarifdetails finden Sie auf der Preisseite.

Fazit

Audio-Ducking kann ein KI-Video verständlicher machen, indem Hintergrundgeräusche abgesenkt werden, während die Sprache Vorrang hat. Im praktischen Workflow erstellen und überprüfen Sie zunächst das Video und formen anschließend den Mix in einem Editor mit Lautstärkeautomation. Prüfen Sie auch das exportierte Ergebnis. Die bereitgestellten Informationen zu Mootion beschreiben Audio-Referenzeingaben und Modi zur Videoerstellung, jedoch keine Ducking-Funktion. Planen Sie den Audiomix daher als separaten Arbeitsschritt ein. Um den Workflow zur Videogenerierung kennenzulernen, besuchen Sie den Arbeitsbereich zur Inhaltserstellung.